실습하는 도중 위와같은 에러를 만났다. arm64는 Apple Silicon용 os인데 인프런 강사의 컴퓨터가 맥이라 arm를 쓰는게 맞지만 저자의 컴퓨터는 윈도우 운영체제라서 amd를 사용하는 것이 맞다. 참고로 amd의 약자는 Advanced Micro Devices 이다.
전체 글
-
The requested image's platform (linux/arm64) does not match the detected host platform (linux/amd64/v3)
 2026.09.20
- window OS 환경에서 gradle 버전 에러 해결하기 2026.09.13
- 집에서 안쓰는 노트북 서버로 만들기 2025.10.25
- ngrinder에서 script validate 시 발생한 에러 2025.09.21
- equals와 hashCode를 올바르게 재정의하는 방법 2025.08.30
- JAVA NIO 2025.08.15 6
- LazyInitializationException과 트랜잭션, 영속성 컨텍스트에 대한 이해 2024.12.01
- Kotlin JDSL에서 Null 값을 가진 조건 무시하기 2024.11.07 1
- Kotlin JDSL 도입기: Page 타입 응답값 반환하기 2024.11.03 1
- React Input 오류 해결 — Uncontrolled to Controlled Transition 2024.10.02
The requested image's platform (linux/arm64) does not match the detected host platform (linux/amd64/v3)
2026. 9. 20. 11:07
window OS 환경에서 gradle 버전 에러 해결하기
2026. 9. 13. 12:42
.인프런을 통해 강의를 공부하던 중 다음 명령어를 사용하게 되었다.
PS C:\Users\TUF\Documents\GitHub\coupon2\coupon> ./gradlew --stop; ./gradlew jibDockerBuild;
그리고 다음과 같은 에러를 마주하게 되었다.
What went wrong:
Gradle requires JVM 17 or later to run. Your build is currently configured to use JVM 11.
해당 문제의 해결 방법은 다음과 같으며 윈도우 OS 환경에서 문제 해결 방법은 다음과 같다.
1. 먼저 JDK 17 버전을 다운로드 한다.
winget install EclipseAdoptium.Temurin.17.JDK
2. 다운로드된 JDK 경로를 확인한다.
Get-ChildItem "C:\Program Files\Eclipse Adoptium" -ErrorAction SilentlyContinue
3. 위 명령어를 사용하여 다음과 같은 결과를 확인한다.
PS C:\Users\TUF\Documents\GitHub\coupon2\coupon>    Get-ChildItem "C:\Program Files\Eclipse Adoptium" -ErrorAction SilentlyContinue

    디렉터리: C:\Program Files\Eclipse Adoptium

Mode                 LastWriteTime         Length Name
----                 -------------         ------ ----
d-----      2026-09-12  오후 11:06                jdk-17.0.20.101-hotspot
4. powerShell에서 해당되든 프로젝트 경로에서 다음 명령어를 수행한다.
notepad .\gradle.properties
5. 그리고 org.gradle.java.home 줄을 아래처럼 수정한다. 각자 Get-childItem에서 얻은 결과를 참조해서 수정하면된다.
org.gradle.java.home=C:\\Program Files\\Eclipse Adoptium\\jdk-17.0.20.101-hotspot
6. 저장후 다음 명령어로 gradle 버전이 잘 수정되었는지 확인한다.
./gradlew --stop
./gradlew -version
7. 명령어를 수행하면 다음과 같은 결과를 얻는다.
PS C:\Users\TUF\Documents\GitHub\coupon2\coupon> ./gradlew -version

------------------------------------------------------------
Gradle 9.7.1
------------------------------------------------------------

Build time:    2026-08-19 14:16:09 UTC
Revision:      92f0512e7f06d84621afba191f75e26536120cf

Kotlin:        2.4.0
Groovy:        4.0.32
Ant:           Apache Ant(TM) version 1.10.17 compiled on April 6 2026
Launcher JVM:  11.0.2 (Oracle Corporation 11.0.2+9)
Daemon JVM:    C:\Program Files\Eclipse Adoptium\jdk-17.0.20.101-hotspot (from org.gradle.java.home)
OS:            Windows 10 10.0 amd64
결과를 확인하면 Launcher JVM은 11.0.2 버전이지만 해당 정보는 gradlew 실행 스크립트를 처음 띄우는 JVM일 뿐이고, 실제 빌드는 Daemon JVM인 17에서 돌아가므로 Daemon JVM이 17 버전인지 확인하면 된다.
'오늘만난오류' 카테고리의 다른 글
집에서 안쓰는 노트북 서버로 만들기
2025. 10. 25. 11:09
aws를 활용한 포트폴리오를 만들면서 프리티어를 사용함에도 달마다 비용이 청구되는 것을 보았다. 그리고 이번에 캐싱을 사용하기 위해서 redis를 도입하려고 하는데 aws에서 redis 서버를 빌리게되면 청구되는 비용이 만만치 않아서 집에서 쓰지 않는 노트북을 서버로 사용하기로 했다.
해당 노트북의 이름은 NT910S3L이며 기본 스펙은 다음과 같다.
프로세서 Intel® Celeron Processor 3855U (1.60 GHz 2MB L3 Cache)
| 메모리 | 4.00GB |
| 시스템 종류 | 64비트 운영 체제 |
| HDD | 128GB |
aws ec2를 쓸 때 주로 사용했던 서버는 우분투 환경이며 우분투 환경에 익숙하기 때문에 우분투 운영체제를 설치하기로 했다.
1. Ununtu Server 설치
먼저 우분투 서버를 설치하기 위해서 우분투 사이트에 방문헤서 최신 버전의 우분투를 설치한다. 우분투를 설치할 때는 LTS가 붙은 것을 설치하는 것이 좋은데 이유는 5년간 보안 및 유지 업데이트를 무료로 해주기 때문이다.
https://ubuntu.com/download/server
2. Rufus 다운로드
우분투 ISO 파일을 USB에 부팅 가능한 설치 미디어로 만들기 위해 Rufus 프로그램을 사용한다. Rufus는 Windows에서 쉽게 부팅 USB를 제작할 수 있는 무료 도구이다.
- 공식 사이트: https://rufus.ie
- 최신 버전 다운로드 후 실행
Refus를 설정할 때 다음과 같이 설정합니다.
- 장치 → 본인 usb(4기가 이상 권장)
- 부팅 선택 → 다운로드한 우분투 서버 ISO 파일
- 파티션 구성 → GPT
위와같이 설정하였다면 나머지 옵션은 기본으로 두고 시작을 선택합니다.
3. 우분투 설치
- USB 연결 및 부팅 순서 변경 노트북에 Rufus로 만든 우분투 USB를 꽂고, 전원을 켠 후 부팅 메뉴 진입 (보통 F2, F10, F12, Del 키 중 하나) → BIOS/UEFI 설정에서 USB를 첫 번째 부팅 장치로 설정
- 우분투 부팅 후 설치 시작
- "Try Ubuntu" 또는 "Install Ubuntu" 선택
- "Minimal installation" 선택
- 디스크 전체 사용 선택 후 설치 진행 (기존 Windows 삭제됨 → 백업 필수!)
- 설치 중 사용자 설정
- 사용자 이름, 비밀번호 설정 (SSH 접속 시 사용)
- OpenSSH server 설치 체크 → 설치 중에 자동으로 SSH 서버 설치됨 (나중에 수동 설치 안 해도 됨!)
- 설치 완료 후 재부팅
- USB 제거 후 재부팅 → 우분투 서버 로그인 화면 등장
4. 포트포워딩
노트북 서버에 접근하기 위해서 먼저 외부에서는 공유기에 접근하여야한다. 저자는 ipTime 공유기를 사용하고있기 때문에 웹 브라우저에 다음 ip(192.168.0.1)를 입력하면 된다. ip를 입력하고 나면 로그인 화면이 나타나게 된다. 초기 설정을 해두지 않았다면 id: admin, pw: admin으로 접속할 수 있다. 다음 화면이 나타나면 관리 도구를 선택한다.
메뉴 탐색기에서 고급설정 > NAT/라우터 관리 > 포트포워드 설정
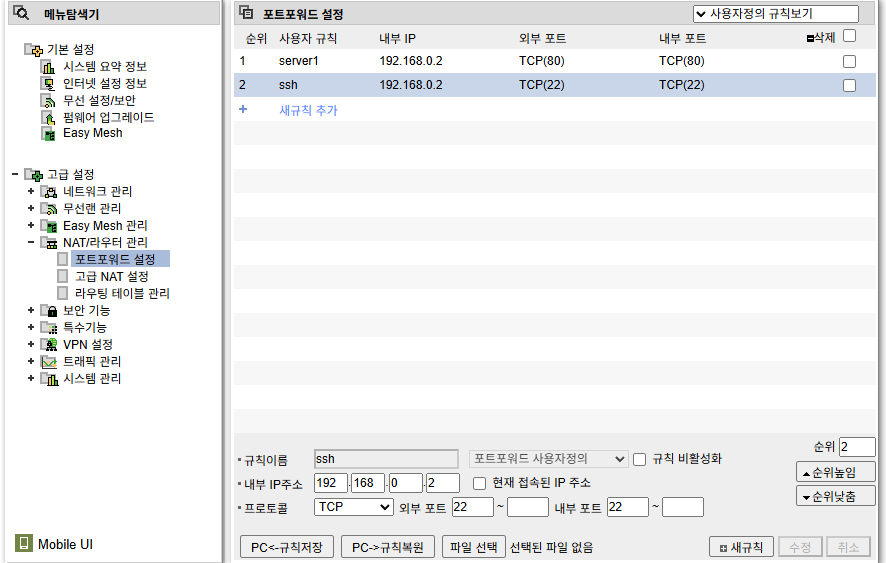
위 화면과 같이 우분투 서버의 내부 IP 주소를 입력하고 외부 포트와 연결할 내부 포트 값을 입력하고 수정하면 된다. 내부 IP 주소를 알기 위해서 ifconfig 명령어를 통해서 알 수 있으며 wlp1s0에 나타나있는 주소가 내부 IP 주소라 할 수 있다.
5. 우분투 초기 환경 세팅
# 우분투의 패키지 관리 도구 업데이트
sudo apt update

# ssh 설치
sudo apt install openssh-server

# ssh 상태 확인 running이 아니라면 start 필요
sudo systemctl status ssh

sudo systemctl start ssh

# 다음 명령어를 통해서 ssh 연결 포트가 22인 것을 볼 수 있고 수정할 수 있다.
vi /etc/ssh/sshd_config
6. 우분투 자동 꺼짐 방지
서버는 24시간 서비스를 제공해야되기 때문에 자동으로 꺼지면 안된다. 그렇기 때문에 기본적으로 전원 절약 모드가 활성화되어있을 수 있기 때문에 이를 비활성화 해야한다. 우분투는 systemd를 통해 시스템의 유휴 상태를 관리합니다. 유휴 상태로 전환 시 종료되는 설정을 비활성화하려면
- logind설정 파일 편집
sudo nano /etc/systemd/logind.conf
- 아래 항목을 찾아 값을 수정하거나 추가
IdelAction=ignore
IdelActionSec=0
- IdleAction=ignore: 유휴 상태에서 아무 작업도 하지 않도록 설정.
- IdleActionSec=0: 유휴 시간 제한을 비활성화.
- 변경 후 logind 서비스 재시작
sudo systemctl restart systemd-logind
7.노트북 덮게 닫아도 꺼지지 않도록 설정
다음 설정 파일로 이동한다.
sudo nano /etc/systemd/logind.conf
다음 값이 있는 줄을 찾아서 주석을 해제하고 값 설정을 다음과 같이 설정한다.
HandleLidSwitch=ignore
HandleLidSwitchExternalPower=ignore   # AC 전원일 때도 동일하게
HandleLidSwitchDocked=ignore          # 도킹 상태일 때도 (필요 시)
변경된 설정을 적용하기 위해서 재시작한다.
sudo systemctl restart systemd-logind
위와같이 우분투 서버를 쓰지 않는 노트북에설치해보았다. 복잡할 것 같은 느낌이였지만 막상 해보니 생각보다 어렵진 않았던 것 같다. 또한 비용을 절약할 수 있는 장점이 생겼다. 하지만 공유기의 IP가 변경될 가능성이 존재하기 때문에 실제 서비스를 구동하기 위해서 사용하려면 고정 아이피를 할당 받아야 할 것이다.
'리눅스 우분투' 카테고리의 다른 글
| 리눅스 로그 분석을 위한 필수 명령어 가이드 (0) | 2024.08.30 |
|---|---|
| vi 유용한 옵션 (0) | 2020.11.13 |
| 우분투 서버 고정 아이피 할당시주의할점 (0) | 2020.11.09 |
| 우분투 서버 18.04 설치(by USB) (0) | 2020.10.29 |
| 리눅스 기초 명령어 정리 (0) | 2020.08.03 |
ngrinder에서 script validate 시 발생한 에러
2025. 9. 21. 14:03
ngrinder를 사용해서 간단한 스크립트를 생성 후 validate 테스트를 해보니 다음과 같은 에러를 얻었다. 구글링 해보니 JDK 버전이 11 or 8이 아니며 그 이상일 경우 발생하는 것으로 보인다.
2025-09-21 12:55:11,242 ERROR Error running worker process
net.grinder.engine.common.EngineException: Setting of Local DNS provider failed
	at net.grinder.engine.process.GrinderProcess.<init>(GrinderProcess.java:154)
	at net.grinder.engine.process.WorkerProcessEntryPoint.run(WorkerProcessEntryPoint.java:78)
	at net.grinder.engine.process.WorkerProcessEntryPoint.main(WorkerProcessEntryPoint.java:60)
Caused by: java.lang.ClassNotFoundException: sun.net.spi.nameservice.NameService
	at java.base/jdk.internal.loader.BuiltinClassLoader.loadClass(BuiltinClassLoader.java:641)
	at java.base/jdk.internal.loader.ClassLoaders$AppClassLoader.loadClass(ClassLoaders.java:188)
	at java.base/java.lang.ClassLoader.loadClass(ClassLoader.java:526)
	at java.base/java.lang.Class.forName0(Native Method)
	at java.base/java.lang.Class.forName(Class.java:421)
	at java.base/java.lang.Class.forName(Class.java:412)
	at org.ngrinder.dns.NameServiceProxy.set(NameServiceProxy.java:59)
	at net.grinder.engine.process.GrinderProcess.<init>(GrinderProcess.java:151)
	... 2 common frames omitted


2025-09-21 12:55:11,244 ERROR worker-bootstrap: Error initialising worker process
net.grinder.engine.common.EngineException: Setting of Local DNS provider failed
	at net.grinder.engine.process.GrinderProcess.<init>(GrinderProcess.java:154)
	at net.grinder.engine.process.WorkerProcessEntryPoint.run(WorkerProcessEntryPoint.java:78)
	at net.grinder.engine.process.WorkerProcessEntryPoint.main(WorkerProcessEntryPoint.java:60)
Caused by: java.lang.ClassNotFoundException: sun.net.spi.nameservice.NameService
	at java.base/jdk.internal.loader.BuiltinClassLoader.loadClass(BuiltinClassLoader.java:641)
	at java.base/jdk.internal.loader.ClassLoaders$AppClassLoader.loadClass(ClassLoaders.java:188)
	at java.base/java.lang.ClassLoader.loadClass(ClassLoader.java:526)
	at java.base/java.lang.Class.forName0(Native Method)
	at java.base/java.lang.Class.forName(Class.java:421)
	at java.base/java.lang.Class.forName(Class.java:412)
	at org.ngrinder.dns.NameServiceProxy.set(NameServiceProxy.java:59)
	at net.grinder.engine.process.GrinderProcess.<init>(GrinderProcess.java:151)
	... 2 common frames omitted
터미널에서 확인해보니 자바 버전이 21로 설정 되어있었다.
$ java --version
openjdk 21.0.2 2024-01-16
OpenJDK Runtime Environment Homebrew (build 21.0.2)
OpenJDK 64-Bit Server VM Homebrew (build 21.0.2, mixed mode, sharing)
자바 버전을 11 혹은 8로 변경하기 위해서 다음과 같은 명령어로 확인해보았다.
$ /usr/libexec/java_home -V
Matching Java Virtual Machines (2):
    11.0.27 (x86_64) "Azul Systems, Inc." - "Zulu 11.80.21" /Library/Java/JavaVirtualMachines/zulu-11.jdk/Contents/Home
    1.8.0_161 (x86_64) "Oracle Corporation" - "Java SE 8" /Library/Java/JavaVirtualMachines/jdk1.8.0_161.jdk/Contents/Home
자바 11 버전으로 변경하기 위해서 다음과 같은 명령어를 사용했다. 다음 명령어를 통해서 일시적으로 jdk 버전을 변경 시킨다. 일시적이라고 하면 명령어를 실행시킨 커맨드 창을 종료하면 원래대로 돌아간다는 의미이다.
export JAVA_HOME=$(/usr/libexec/java_home -v 11.0.27)
source ~/.bash_profile
다음 명령어를 통해서 영구적으로 자바 버전을 변경할 수 있다.
vim ~/.zshrc 실행 후 아래 내용을 삽입
export JAVA_HOME=$(/usr/libexec/java_home -v 11.0.27)
하지만 나의 경우 이미 export JAVA_HOME=$(/usr/libexec/java_home -v 1.8)로 들어가있어서 이를 11.0.27 버전으로 수정했다.
다음 명령어를 수행해서 변경사항을 반영한다.
source ~/.zshrc
자바 버전을 확인해보니 다음과 같이 잘 변경된 것을 확인할 수 있었다.
$ java --version
openjdk 11.0.27 2025-04-15 LTS
OpenJDK Runtime Environment Zulu11.80+21-CA (build 11.0.27+6-LTS)
OpenJDK 64-Bit Server VM Zulu11.80+21-CA (build 11.0.27+6-LTS, mixed mode)
문제 해결을 위해서 다음 블로그를 참조했습니다.
https://8156217.tistory.com/62
'JAVA' 카테고리의 다른 글
| equals와 hashCode를 올바르게 재정의하는 방법 (0) | 2025.08.30 |
|---|---|
| JAVA NIO (6) | 2025.08.15 |
equals와 hashCode를 올바르게 재정의하는 방법
2025. 8. 30. 15:12
equals와 hashCode를 올바르게 재정의하는 방법
자바에서 equals와 hashCode 메서드는 객체의 논리적 동치성과 해시 기반 컬렉션에서의 동작을 결정하는 핵심 요소입니다. Object 클래스에서 제공하는 기본 구현은 참조 동일성을 비교하지만, 논리적 동치성을 비교하려면 이를 적절히 재정의해야 합니다. 이 글에서는 equals와 hashCode를 재정의할 때 지켜야 할 규약과 주의 사항을 살펴보겠습니다.
equals를 재정의하지 않는 것이 좋은 경우
다음과 같은 상황에서는 equals 메서드를 재정의하지 않는 것이 적절합니다:
- 각 인스턴스가 본질적으로 고유한 경우
예를 들어, Thread와 같이 각 객체가 고유한 식별성을 가지는 경우에는 논리적 동치성을 비교할 필요가 없습니다. - 논리적 동치성을 검사할 필요가 없는 경우
객체의 논리적 동치성을 비교할 일이 없는 클래스에서는 equals를 재정의할 필요가 없습니다. - 상위 클래스의 equals가 하위 클래스에 적합한 경우
상위 클래스에서 이미 적절히 재정의된 equals 메서드가 하위 클래스에서도 충분히 동작한다면 재정의가 필요 없습니다. 예: java.util.AbstractList의 equals는 하위 클래스에서도 잘 동작합니다. - 클래스가 private 또는 package-private이고 equals 호출이 없는 경우
equals 메서드가 호출될 일이 없는 클래스라면 재정의할 필요가 없습니다. 실수로 호출되는 것을 방지하기 위해 다음과 같이 방어적으로 작성할 수 있습니다: - @Override public boolean equals(Object o) { throw new AssertionError("equals 메서드가 호출되지 않아야 합니다."); }
equals를 재정의하는 것이 좋은 경우
equals 메서드는 객체의 논리적 동치성을 비교해야 할 때 재정의해야 합니다. 특히, 상위 클래스의 equals가 논리적 동치성을 비교하도록 설계되지 않은 경우가 이에 해당합니다. 예를 들어, Set이나 Map의 키로 사용되는 객체는 논리적 동치성을 기반으로 동작하므로 equals를 적절히 재정의해야 합니다.
equals 메서드의 일반 규약
equals 메서드를 재정의할 때는 다음 다섯 가지 규약을 반드시 준수해야 합니다:
- 반사성(reflexivity): null이 아닌 모든 참조 값 x에 대해, x.equals(x)는 true를 반환해야 합니다.
- 대칭성(symmetry): null이 아닌 모든 참조 값 x, y에 대해, x.equals(y)가 true이면 y.equals(x)도 true여야 합니다.
- 추이성(transitivity): null이 아닌 모든 참조 값 x, y, z에 대해, x.equals(y)가 true이고 y.equals(z)가 true이면, x.equals(z)도 true여야 합니다.
- 일관성(consistency): null이 아닌 모든 참조 값 x, y에 대해, x.equals(y)를 반복 호출하면 항상 동일한 결과를 반환해야 합니다(객체의 상태가 변경되지 않는 한).
- null-아님: null이 아닌 모든 참조 값 x에 대해, x.equals(null)은 false를 반환해야 합니다.
equals 재정의 시 주의 사항
- 구체 클래스의 확장과 값 추가: 구체 클래스를 확장하면서 새로운 값을 추가하는 경우, equals 규약을 만족시키는 것은 불가능합니다. 이를 해결하려면 상속 대신 컴포지션(composition)을 사용하세요.
- 신뢰할 수 없는 자원 사용 금지: equals 메서드는 클래스 내부의 필드만 사용해야 하며, 외부의 신뢰할 수 없는 자원(예: 파일, 네트워크)에 의존해서는 안 됩니다.
- 입력 타입은 Object여야 함: equals 메서드의 매개변수는 반드시 Object 타입이어야 하며, 특정 클래스 타입으로 제한하면 규약을 위반하게 됩니다.
equals 재정의 단계
equals 메서드를 재정의할 때는 다음 단계를 따르는 것이 좋습니다:
- == 연산자로 참조 동일성 확인: 입력이 자기 자신의 참조인지 확인합니다.
- instanceof 연산자로 타입 확인: 입력이 올바른 타입인지 확인합니다.
- 형변환: 입력을 올바른 타입으로 형변환합니다.
- 핵심 필드 비교: 입력 객체와 자기 자신의 대응되는 핵심 필드들이 모두 일치하는지 확인합니다.
- float/double 비교: float와 double 필드는 각각 Float.compare(float, float)와 Double.compare(double, double)를 사용해 비교합니다.
예제: equals 메서드 구현
@Override
public boolean equals(Object o) {
    if (o == this) return true; // 참조 동일성 확인
    if (!(o instanceof MyClass)) return false; // 타입 확인
    MyClass other = (MyClass) o; // 형변환
    return this.field1 == other.field1 && // 핵심 필드 비교
           Objects.equals(this.field2, other.field2) &&
           Float.compare(this.field3, other.field3) == 0;
}- Objects.equals: null 안전한 비교를 위해 사용.
- Float.compare/Double.compare: 부동소수점 비교 시 정확성을 보장.
hashCode를 재정의해야 하는 이유
equals 메서드를 재정의한 클래스는 반드시 hashCode 메서드도 재정의해야 합니다. 그렇지 않으면 HashMap, HashSet 같은 해시 기반 컬렉션에서 객체가 예상대로 동작하지 않을 수 있습니다. 이는 Object 클래스의 hashCode 일반 규약을 위반하기 때문입니다.
hashCode 일반 규약
Object 클래스의 API 문서에 명시된 hashCode의 규약은 다음과 같습니다:
- 일관성: 동일한 객체에서 hashCode를 여러 번 호출하면, 객체의 상태가 변경되지 않는 한 항상 동일한 값을 반환해야 합니다.
- equals와의 일치: equals 메서드에서 같은 객체로 판단되는 두 객체는 동일한 hashCode 값을 반환해야 합니다.
- 분산성: equals로 다른 객체로 판단되는 객체들은 가능한 한 서로 다른 hashCode 값을 반환해야 합니다(필수는 아니지만 성능에 영향을 미침).
hashCode를 재정의하지 않을 때의 문제
equals를 재정의했지만 hashCode를 재정의하지 않으면, 논리적으로 동일한 객체가 다른 해시코드를 반환할 수 있습니다. 이는 HashMap이나 HashSet에서 객체를 찾거나 저장할 때 문제를 일으킵니다. 예를 들어:
- HashMap에서 키로 사용된 객체를 찾을 수 없음.
- HashSet에서 동일한 객체가 중복으로 추가됨.
hashCode 구현 가이드라인
- 핵심 필드 사용: equals에서 사용하는 모든 핵심 필드를 hashCode 계산에 포함해야 합니다. 핵심 필드를 생략하면 논리적 동치성을 보장할 수 없습니다.
- 효율성과 분산성 고려: 해시코드는 가능한 한 고르게 분포해야 하며, 계산이 너무 복잡하지 않아야 합니다.
- API 문서에 계산 방식 비공개: hashCode의 구현 세부 사항을 API 문서에 공개하지 말아야 합니다. 이는 나중에 구현을 변경할 유연성을 제공합니다.
예제: hashCode 메서드 구현
@Override
public int hashCode() {
    int result = 17; // 초기값(소수 권장)
    result = 31 * result + field1; // 기본 타입
    result = 31 * result + Objects.hashCode(field2); // 객체 필드
    result = 31 * result + Float.floatToIntBits(field3); // 부동소수점
    return result;
}- 31 사용 이유: 홀수 소수로 곱셈을 통해 해시 충돌 가능성을 줄입니다.
- Objects.hashCode: null 안전한 해시 계산.
- Float.floatToIntBits: 부동소수점 값을 정수로 변환.
추가 팁
- 너무 복잡하게 구현하지 말자: equals와 hashCode는 간단하고 명확하게 작성해야 유지보수가 쉽습니다.
- AutoValue 또는 IDE 활용: Google의 AutoValue 프레임워크나 IntelliJ, Eclipse 같은 IDE는 equals와 hashCode를 자동으로 생성해줍니다.
- 성능 최적화: 지나치게 복잡한 hashCode 계산은 성능을 저하시킬 수 있으므로 적절히 균형을 맞추세요.
- 캐싱 고려: 불변 객체의 경우 hashCode 값을 캐싱하여 성능을 최적화할 수 있습니다.
결론
equals 메서드를 재정의할 때는 반드시 hashCode도 재정의해야 합니다. 이는 해시 기반 컬렉션(HashMap, HashSet 등)에서 올바른 동작을 보장하기 위해 필수적입니다. equals와 hashCode는 일반 규약을 준수하고, equals에서 사용하는 핵심 필드를 모두 포함해야 합니다. AutoValue나 IDE의 자동 생성 기능을 활용하면 규약을 준수하는 equals와 hashCode를 쉽게 구현할 수 있습니다.
본 내용은 『Effective Java』를 참조하여 작성되었습니다.
'JAVA' 카테고리의 다른 글
| ngrinder에서 script validate 시 발생한 에러 (0) | 2025.09.21 |
|---|---|
| JAVA NIO (6) | 2025.08.15 |
JAVA NIO
2025. 8. 15. 15:54
Java NIO 이해하기: 버퍼, 채널, 셀렉터
Java NIO(New Input/Output)는 입출력 작업을 비동기적이고 효율적으로 처리하기 위한 강력한 API입니다. 기존 Java IO는 스트림과 멀티스레딩에 의존하여 다수의 클라이언트를 처리했지만, NIO는 버퍼, 채널, 셀렉터를 활용해 성능과 확장성을 최적화합니다. 이 글에서는 Java NIO의 핵심 구성 요소인 다이렉트/논다이렉트 버퍼, 채널, 셀렉터의 역할을 정리합니다.
다이렉트 버퍼 vs 논다이렉트 버퍼
NIO의 버퍼는 채널에서 데이터를 읽거나 쓰기 위해 사용됩니다. 버퍼는 다이렉트 버퍼와 논다이렉트 버퍼로 나뉘며, 각각의 특징은 다음과 같습니다:
버퍼의 특징
- 버퍼 생성 속도:
- 논다이렉트 버퍼: JVM의 힙 메모리에 할당되므로 생성 속도가 빠릅니다.
- 다이렉트 버퍼: 운영체제의 네이티브 메모리에 할당되므로 생성 속도가 느립니다.
- 입출력 성능:
- 논다이렉트 버퍼: JVM 힙과 네이티브 메모리 간 데이터 복사로 인해 입출력 성능이 낮습니다.
- 다이렉트 버퍼: 네이티브 메모리에 직접 접근하므로 입출력 성능이 더 뛰어납니다.
- 메모리 종류:
- 논다이렉트 버퍼: JVM의 힙 메모리에 저장되며, 가비지 컬렉터에 의해 관리됩니다.
- 다이렉트 버퍼: 운영체제의 네이티브 메모리에 할당되어 JVM 힙 관리를 우회합니다.
활용 사례: 다이렉트 버퍼는 네트워크나 파일 입출력과 같은 고성능 작업에 적합하며, 논다이렉트 버퍼는 입출력 부하가 적고 빠른 메모리 할당이 필요한 경우에 유용합니다.
NIO의 채널
기존 IO는 단방향 스트림(읽기 또는 쓰기 중 하나)을 사용하지만, NIO의 채널은 양방향으로 읽기와 쓰기를 모두 지원합니다. 채널은 항상 버퍼와 함께 사용되며, 데이터를 버퍼에 저장하거나 버퍼에서 읽어옵니다.
채널을 사용하는 이유
- 양방향성: 읽기와 쓰기를 동시에 지원하여 기존 IO 스트림보다 유연합니다.
- 비동기 처리: 비동기 모드를 지원해 단일 스레드로 다수의 클라이언트를 효율적으로 처리할 수 있습니다.
- 효율성: 버퍼와 함께 작동하여 데이터 복사를 최소화하고 입출력 효율성을 높입니다.
주요 채널 유형
- ServerSocketChannel: 서버에서 클라이언트 연결 요청을 수신하는 데 사용됩니다. 비동기 모드로 설정해 다수의 클라이언트 연결을 효율적으로 처리하며, 셀렉터와 함께 사용됩니다.
- SocketChannel: 클라이언트와 서버 간의 단일 연결을 관리하며 데이터를 읽고 쓰는 데 사용됩니다. 비동기 모드를 지원해 높은 동시성을 제공합니다.
셀렉터(Selector)의 역할
셀렉터는 단일 스레드로 다수의 채널을 관리할 수 있게 해주는 NIO의 핵심 구성 요소입니다. 셀렉터는 채널의 특정 이벤트(예: 연결 요청, 데이터 읽기 준비, 데이터 쓰기 준비)를 모니터링하고, 이벤트 발생 시 애플리케이션에 알립니다.
셀렉터를 사용하는 이유
- 멀티플렉싱: 단일 스레드로 다수의 채널을 관리하여 기존 IO의 스레드당 클라이언트 처리 방식을 대체합니다. 이는 수천 개의 동시 연결을 처리하는 서버에 적합합니다.
- 비동기 입출력: 비동기 모드의 채널과 함께 작동하여 준비된 채널만 처리하므로 리소스 사용을 최적화합니다.
- 효율성: 셀렉터는 준비된 채널만 선택적으로 처리해 성능을 향상시킵니다.
셀렉터 동작 방식
- ServerSocketChannel을 셀렉터에 등록하여 연결 요청(OP_ACCEPT)을 감시합니다.
- 클라이언트 연결이 발생하면 셀렉터가 이를 감지하고, 애플리케이션은 연결을 수락해 SocketChannel을 생성합니다.
- SocketChannel을 셀렉터에 등록하여 읽기(OP_READ) 또는 쓰기(OP_WRITE)를 감시합니다.
- 셀렉터는 등록된 모든 채널을 지속적으로 모니터링하며 준비된 채널을 애플리케이션에 알립니다.
ServerSocketChannel과 SocketChannel의 역할
- ServerSocketChannel:
- 목적: 서버에서 클라이언트의 연결 요청을 수신합니다.
- 비동기 지원: 비동기 모드로 다수의 연결 요청을 단일 스레드로 처리할 수 있습니다.
- 활용 사례: 확장 가능한 서버 구축에 필수적이며, 다수의 클라이언트 연결을 효율적으로 관리합니다.
- SocketChannel:
- 목적: 클라이언트와 서버 간의 단일 연결에서 데이터 읽기와 쓰기를 처리합니다.
- 비동기 지원: 비동기 모드로 동작하여 스레드를 블록하지 않고 입출력을 처리합니다.
- 활용 사례: TCP 연결을 통한 클라이언트-서버 통신에 사용됩니다.
기존 IO vs NIO
기존 Java IO:
- 클라이언트당 전용 스레드가 필요하여 다수의 클라이언트를 처리할 때 리소스 소모가 큽니다.
- 스트림은 단방향(읽기 또는 쓰기)만 지원합니다.
Java NIO:
- 채널과 셀렉터를 활용해 단일 스레드로 다수의 클라이언트를 처리하여 확장성을 높입니다.
- 양방향 채널을 지원하여 읽기와 쓰기를 동시에 처리할 수 있습니다.
- 다이렉트 버퍼를 통해 입출력 성능을 최적화합니다.
결론
Java NIO는 다이렉트/논다이렉트 버퍼, 양방향 채널, 셀렉터를 통해 고성능, 확장 가능한 애플리케이션 개발을 가능하게 합니다. ServerSocketChannel과 SocketChannel을 셀렉터와 함께 사용하면 다수의 클라이언트를 효율적으로 관리할 수 있습니다. NIO의 이러한 특징을 이해하고 활용하면 네트워크 프로그래밍에서 높은 성능과 확장성을 달성할 수 있습니다.
'JAVA' 카테고리의 다른 글
| ngrinder에서 script validate 시 발생한 에러 (0) | 2025.09.21 |
|---|---|
| equals와 hashCode를 올바르게 재정의하는 방법 (0) | 2025.08.30 |
LazyInitializationException과 트랜잭션, 영속성 컨텍스트에 대한 이해
2024. 12. 1. 22:33
개발을 하다 보면 JPA와 Hibernate를 사용하는 환경에서 LazyInitializationException을 마주치게 될 때가 있습니다. 특히 연관 데이터를 지연 로딩(Lazy Loading)으로 설정했을 때 트랜잭션 종료 이후 데이터를 로드하려 하면 이 문제가 발생합니다. 이번 글에서는 LazyInitializationException이 무엇인지, 왜 발생하는지, 그리고 이를 해결하기 위해 필요한 트랜잭션, 영속성 컨텍스트, 준영속성에 대해 설명합니다.
1. LazyInitializationException이란?
LazyInitializationException은 JPA에서 지연 로딩(Lazy Loading)으로 설정된 연관 데이터를 트랜잭션 종료 이후 로드하려고 할 때 발생하는 예외입니다. Lazy Loading은 실제로 데이터가 필요할 때만 쿼리를 실행하여 데이터를 가져오는 방식이지만, 트랜잭션이 종료된 후에는 영속성 컨텍스트가 닫혀 데이터베이스에 접근할 수 없으므로 예외가 발생합니다.
2. 예제 코드
Circle 엔티티와 CircleSchedule 엔티티를 사용한 예제를 통해 설명합니다.
@Entity
class Circle(
    @Id
    @GeneratedValue
    val id: UUID = UUID.randomUUID(),

    val title: String,

    @OneToMany(mappedBy = "circle", fetch = FetchType.LAZY, cascade = [CascadeType.ALL])
    val circleSchedules: MutableList<CircleSchedule> = mutableListOf()
)
CircleSchedule 엔티티
@Entity
class CircleSchedule(
    @Id
    @GeneratedValue
    val id: UUID = UUID.randomUUID(),

    @ManyToOne(fetch = FetchType.LAZY)
    val circle: Circle,

    val dayOfWeek: String,
    val startTime: String,
    val endTime: String
)
3. 문제 상황: LazyInitializationException 발생
아래 코드에서 circle.circleSchedules는 Lazy Loading으로 설정되어 있습니다. 트랜잭션이 종료된 후 circleSchedules에 접근하려 하면 LazyInitializationException이 발생합니다.
문제 코드
fun getCircleSchedules(circleId: UUID): List<CircleSchedule> {
    val circle = circleRepository.findById(circleId)
        .orElseThrow { NotExistException("Circle not found") }
    return circle.circleSchedules // LazyInitializationException 발생 가능
}
발생 이유
- circle.circleSchedules는 FetchType.LAZY로 설정되어 있어, 기본적으로 데이터베이스 쿼리를 실행하지 않습니다.
- 트랜잭션이 종료되면 영속성 컨텍스트도 종료되므로, 지연 로딩된 데이터를 가져올 수 없습니다.
4. LazyInitializationException 해결 방법
1) @Transactional 사용
트랜잭션 내에서 지연 로딩 데이터에 접근하도록 @Transactional을 적용합니다.
@Transactional(readOnly = true)
fun getCircleSchedules(circleId: UUID): List<CircleSchedule> {
    val circle = circleRepository.findById(circleId)
        .orElseThrow { NotExistException("Circle not found") }
    return circle.circleSchedules // Lazy Loading 가능
}
2) Open-Session-In-View 설정
Spring Boot에서 spring.jpa.open-in-view 설정을 활성화하면 트랜잭션이 종료된 이후에도 Lazy Loading이 가능합니다. 하지만 이 방법은 권장되지 않습니다.
application.yml 설정:
spring:
  jpa:
    open-in-view: true
5. 영속성 컨텍스트와 트랜잭션
영속성 컨텍스트(Persistence Context)
영속성 컨텍스트는 JPA 엔티티를 관리하며 데이터베이스와의 상호작용을 처리하는 캐시 역할을 합니다.
- 트랜잭션이 시작되면 영속성 컨텍스트가 활성화됩니다.
- 트랜잭션이 종료되면 영속성 컨텍스트도 종료됩니다.
- Lazy Loading은 영속성 컨텍스트 내에서만 작동합니다.
트랜잭션 종료 이후의 Lazy Loading
트랜잭션이 종료되면 영속성 컨텍스트가 종료되고, Lazy Loading 데이터는 로드할 수 없습니다. 이를 방지하려면 트랜잭션 내부에서 데이터를 로드해야 합니다.
6. 결론
- LazyInitializationException은 트랜잭션 종료 이후 Lazy Loading 데이터를 로드하려 할 때 발생합니다.
- @Transactional 등을 활용하여 LazyInitializationException을 방지할 수 있습니다.
- 영속성 컨텍스트와 트랜잭션의 생명주기를 이해하면 Lazy Loading 문제를 더 잘 해결할 수 있습니다.
'JPA' 카테고리의 다른 글
| Kotlin, JPA 환경에서 Entity 설계에 대한 고민 (0) | 2024.09.08 |
|---|---|
| 자바 ORM 표준 JPA 프로그래밍 기본편 정리 1탄 (0) | 2022.08.07 |
| @Enumerated (0) | 2022.07.25 |
Kotlin JDSL에서 Null 값을 가진 조건 무시하기
2024. 11. 7. 21:13
프로젝트를 진행하다 보면 다양한 조건을 기반으로 데이터를 검색해야 할 때가 많습니다. 예를 들어, title, englishLevel, city와 같은 조건을 이용해 Circle 데이터를 검색할 때, 이들 조건이 null일 경우 해당 조건을 무시하고 싶을 수 있습니다. 이런 경우 Kotlin JDSL에서는 null 값 조건을 쉽게 무시하는 방법을 제공하며, 이번 글에서는 이를 어떻게 적용할 수 있는지 설명드리겠습니다.
문제 상황
아래와 같은 쿼리를 작성했다고 가정해보겠습니다.
override fun findCirclesByPagination(pageable: Pageable, request: CircleSearchRequest?)
: Page<CirclePageResponse?> {
    return kotlinJdslJpqlExecutor.findPage(pageable) {
        selectNew<CirclePageResponse>(
                path(Circle::id),
                path(Circle::thumbnailUrl),
                path(Circle::title),
                path(Circle::introduction),
                path(Member::profile).`as`(expression("leaderProfile")),
                path(Member::nickname).`as`(expression("leaderName")),
                path(Circle::englishLevel),
                path(Circle::city),
                path(Circle::capacity),
                path(Circle::totalView),
                path(Circle::totalLike),
        ).from(
                entity(Circle::class),
                join(Circle::leader)
        ).whereAnd(
                path(Circle::title).like("%${request?.title}%"),
                path(Circle::englishLevel).eq(request?.level),
                path(Circle::city).eq(request?.city)
        )
    }
}
여기서 우리는 title, englishLevel, city 세 가지 조건을 사용하고 있습니다. 하지만 이 필드들 중 하나라도 null일 경우 쿼리에서 해당 조건을 무시해야 할 때 어떻게 해야 할까요?
해결 방법: 조건을 let으로 감싸기
Kotlin JDSL에서는 whereAnd 블록 내에서 조건을 동적으로 추가할 수 있습니다. let 함수를 활용해 각 조건이 null이 아닐 때만 적용되도록 설정해보겠습니다.
override fun findCirclesByPagination(pageable: Pageable, request: CircleSearchRequest?)
: Page<CirclePageResponse?> {
    return kotlinJdslJpqlExecutor.findPage(pageable) {
        selectNew<CirclePageResponse>(
                path(Circle::id),
                path(Circle::thumbnailUrl),
                path(Circle::title),
                path(Circle::introduction),
                path(Member::profile).`as`(expression("leaderProfile")),
                path(Member::nickname).`as`(expression("leaderName")),
                path(Circle::englishLevel),
                path(Circle::city),
                path(Circle::capacity),
                path(Circle::totalView),
                path(Circle::totalLike),
        ).from(
                entity(Circle::class),
                join(Circle::leader)
        ).whereAnd(
                request?.title?.let { path(Circle::title).like("%$it%") },
                request?.level?.let { path(Circle::englishLevel).eq(it) },
                request?.city?.let { path(Circle::city).eq(it) }
        )
    }
}
코드 설명
- 조건 추가를 위한 let 사용: request?.title, request?.level, request?.city가 각각 null이 아닐 때만 let 블록 내부의 조건이 실행되어 쿼리에 추가됩니다.
- null 값 무시: title, level, city 중 하나라도 null이면 해당 조건은 자동으로 쿼리에서 제외됩니다.
동작 방식 예시
- title만 null인 경우: englishLevel과 city만 조건으로 포함됩니다.
- 모든 값이 null인 경우: 조건 없이 전체 결과가 반환됩니다.
이를 통해 null 조건을 유연하게 무시하고 원하는 조건에 따라 필터링된 결과를 반환받을 수 있습니다.
마무리
Kotlin JDSL에서 조건을 동적으로 설정하는 것은 상당히 직관적이며, let 함수와 같은 Kotlin의 기능을 활용해 쿼리의 가독성을 높일 수 있습니다. 이 방식은 특히 검색 기능을 구현할 때 유용하며, nullable 필드를 조건으로 사용할 때 코드의 안정성과 효율성을 높여줍니다.
이번 글에서는 Kotlin JDSL을 사용해 조건이 null인 경우 쿼리에서 해당 조건을 제외하는 방법을 살펴보았습니다. 앞으로 JDSL을 활용해 다양한 쿼리를 동적으로 구성할 때 큰 도움이 되길 바랍니다.
'Kotlin-Jdsl' 카테고리의 다른 글
| Kotlin JDSL 도입기: Page 타입 응답값 반환하기 (1) | 2024.11.03 |
|---|
Kotlin JDSL 도입기: Page 타입 응답값 반환하기
2024. 11. 3. 21:33
최근 프로젝트에서 Kotlin JDSL을 도입하며, 특히 페이지네이션된 데이터를 반환할 때 몇 가지 문제에 직면했습니다. 자료가 부족하거나 오래되어 직접 구현하기 쉽지 않았지만, 공식 문서와 GitHub 테스트 코드를 참고하여 문제를 해결할 수 있었습니다. 이번 글에서는 해결 과정을 코드와 함께 공유하고자 합니다.
문제 해결 과정: Page 타입 응답 구현
페이지네이션된 데이터를 반환하기 위해 KotlinJdslJpqlExecutor의 findPage 메서드와 selectNew를 사용했습니다. selectNew 메서드는 엔티티가 아닌 사용자 정의 DTO로 데이터를 매핑할 수 있어 매우 유용합니다. 아래는 구현한 코드입니다
@Repository
class CustomCircleRepositoryImpl(
    private val kotlinJdslJpqlExecutor: KotlinJdslJpqlExecutor
) : CustomCircleRepository {

    override fun findCirclesByPagination(pageable: Pageable): Page<CirclePageResponse?> {
        return kotlinJdslJpqlExecutor.findPage(pageable) {
            selectNew<CirclePageResponse>(
                path(Circle::id),
                path(Circle::thumbnailUrl),
                path(Circle::title),
                path(Circle::introduction),
                path(Member::profile).`as`(expression("leaderProfile")),
                path(Member::nickname).`as`(expression("leaderName")),
                path(Circle::englishLevel),
                path(Circle::city),
                path(Circle::capacity),
                path(Circle::totalView),
                path(Circle::totalLike)
            ).from(
                entity(Circle::class),
                join(Circle::leader)
            )
        }
    }
}
코드 설명
- CustomCircleRepositoryImpl 클래스: KotlinJdslJpqlExecutor를 주입받아 findCirclesByPagination 메서드를 구현한 커스텀 리포지토리입니다.
- findCirclesByPagination 메서드: Pageable 객체를 인자로 받아 Page<CirclePageResponse?> 타입의 응답을 반환합니다. 이 메서드는 JPA의 Page 기능을 활용해 페이지네이션된 데이터를 반환하도록 설계되었습니다.
- selectNew 메서드: Kotlin JDSL의 핵심 기능 중 하나로, CirclePageResponse라는 사용자 정의 DTO에 엔티티 데이터를 매핑합니다. path 메서드를 통해 각 필드를 선택하며, DTO 필드와 일치하도록 매핑합니다. Member 엔티티에서 리더의 프로필과 닉네임을 가져오기 위해 join을 사용했습니다.
DTO 설계와 발생한 이슈
페이지네이션을 위해 사용하는 CirclePageResponse는 다음과 같은 구조를 가지고 있습니다:
@Schema(description = "서클 페이지 조회 응답")
data class CirclePageResponse(
    val id: UUID,
    val thumbnailUrl: String? = null,
    val title: String,
    val introduction: String = "",
    val leaderProfile: String? = null,
    val leaderName: String,
    val englishLevel: EnglishLevel,
    val city: City,
    val capacity: Int,
    val totalView: Int,
    val totalLike: Int,
    val likedByMe: Boolean = false
)
이슈: selectNew 메서드의 제한 사항
selectNew를 사용할 때, DTO의 생성자 파라미터에 정확히 일치하는 개수와 순서대로 값을 할당해야 합니다. likedByMe 필드는 기본값이 false로 설정되어 있었지만, selectNew는 기본값을 무시하고 모든 파라미터에 값을 전달하도록 강제합니다. 이로 인해 초기 코드에서 오류가 발생했습니다.
해결 방법
이 문제를 해결하기 위해 likedByMe 필드를 생성자 밖으로 이동하여 기본값을 설정하도록 변경했습니다. 수정된 DTO는 다음과 같습니다.
@Schema(description = "서클 페이지 조회 응답")
data class CirclePageResponse(
    val id: UUID,
    val thumbnailUrl: String? = null,
    val title: String,
    val introduction: String = "",
    val leaderProfile: String? = null,
    val leaderName: String,
    val englishLevel: EnglishLevel,
    val city: City,
    val capacity: Int,
    val totalView: Int,
    val totalLike: Int
) {
    val likedByMe: Boolean = false
}
이제 selectNew는 DTO의 모든 생성자 파라미터에 값을 할당할 필요가 없어졌습니다. likedByMe 필드는 클래스 바디에 정의되어 기본값 false로 설정됩니다. 이로써 selectNew의 제한 사항을 우회하면서 원하는 데이터를 매핑할 수 있었습니다.
'Kotlin-Jdsl' 카테고리의 다른 글
| Kotlin JDSL에서 Null 값을 가진 조건 무시하기 (1) | 2024.11.07 |
|---|
React Input 오류 해결 — Uncontrolled to Controlled Transition
2024. 10. 2. 22:43
들어가며
React에서 "A component is changing an uncontrolled input to be controlled"*라는 경고 메시지를 만난 적이 있나요? 이 에러는 보통 input 요소가 uncontrolled 상태로 시작했다가, 이후 controlled 상태로 변환될 때 발생합니다. 이러한 경고는 개발 환경에서만 표시되지만, 무시하고 넘어가면 앱의 일관성과 안정성에 문제가 생길 수 있습니다.
이번 글에서는 이 문제를 해결하는 방법을 예시 코드와 함께 알아보겠습니다.
Uncontrolled와 Controlled Input 차이
Uncontrolled input은 React가 그 값을 관리하지 않는 입력 요소를 의미합니다. 사용자가 입력한 값을 직접적으로 DOM이 관리하고, React의 상태로부터 독립적인 상태로 동작합니다. 반대로 Controlled input은 React 상태에 의해 관리되는 입력 요소로, 사용자가 입력한 값이 항상 React의 state에 저장되며 상태에 따라 값이 동적으로 변화합니다.
문제는 다음과 같은 상황에서 발생합니다:
- input 필드가 처음에 undefined 또는 null 값으로 설정되어 uncontrolled로 시작된 후, 나중에 controlled 상태로 변경되는 경우입니다.
경고 메시지
에러 메시지는 다음과 같은 형태로 나타납니다:
Warning: A component is changing an uncontrolled input to be controlled. This is likely caused by the value changing from undefined to a defined value, which should not happen.
이러한 경고는 필드의 value가 처음에 정의되지 않았기 때문에 uncontrolled로 시작하고, 이후에 정의된 값이 할당되면서 controlled 상태로 전환될 때 발생합니다.
문제 해결 방법
문제를 해결하려면 input 필드의 value를 항상 정의된 값으로 초기화해야 합니다. 즉, 빈 문자열('')을 사용하여 controlled 상태를 유지하는 것이 중요합니다.
예를 들어, 다음과 같은 코드를 살펴보겠습니다:
useEffect(() => {
  if (!profile) {
    setProfile({
      name: '',
      nickname: '',
      email: '',
      password: '',
      newPassword: '',
      confirmNewPassword: '',
      profileImage: '', // 빈 문자열로 초기화
      isMarketingAgreed: false // 기본값 false
    })
  }
}, [])
위 코드는 profile 값이 undefined일 경우, setProfile을 호출하여 빈 문자열로 모든 필드를 초기화하는 방법입니다. 이렇게 함으로써 React는 input 요소를 항상 controlled 상태로 유지할 수 있습니다.
'프론트엔드' 카테고리의 다른 글
| Axios와 Fetch API 비교: 어떤 것을 선택해야 할까? (0) | 2024.08.24 |
|---|